Описание
Модуль платформы Smart Monitor для мониторинга ИТ-систем, сервисов и приложений. МАЯК обеспечивает наблюдаемость на инфраструктурном, сервисном и прикладном уровнях: объединяет метрики, логи и трассировки в единые модели здоровья, чтобы не просто фиксировать события, а показывать, как изменения в инфраструктуре влияют на сервисы, бизнес-процессы и пользовательский опыт.
В основе лежит динамическая модель зависимостей и здоровья сервисов, которая автоматически перестраивается при изменениях инфраструктуры на основе данных модуля Инвентаризации. К объектам модели привязываются метрики, события, логи и трассировки из разных источников, после чего система анализирует их взаимосвязи, рассчитывает состояние сервисов и определяет вероятные причины отклонений.
Для кого: ИТ-эксплуатация, SRE-команды, владельцы ИТ-сервисов и бизнес-заказчики — для каждой роли собирается свой центр аналитики.
От данных к модели здоровья
Четыре уровня: сырые данные превращаются в метрики со шкалой здоровья, метрики — в сервисы, сервисы — в модель зависимостей.
1ДанныеМетрики, логи, трассировки, журналы, данные инвентаризации и другие источники платформы.
2МетрикиАтомарная единица с алгоритмом расчёта здоровья: поисковый запрос извлекает значение и размерности (хост, pod, endpoint), результат приводится к шкале здоровья 0–100.
3СервисыЛогическая сущность: бизнес-сервис, микросервис, слой хранения данных или физический сервер. Здоровье сервиса — функция от привязанных метрик и дочерних сервисов.
4Модель здоровьяСвязи и влияние: у каждой зависимости свой вес, состояние верхних уровней собирается из состояния нижних.
Алгоритмы расчёта здоровья метрики. Значение метрики бывает количественным (число сравнивается с порогом) и качественным (строка сопоставляется с паттерном). Коридор нормы задаётся статическими порогами, рассчитывается адаптивно по истории значений (σ, перцентили, MAD с доверительными интервалами по временным окнам и учётом сезонности) либо определяется ML-моделью; для разных групп объектов по фильтрам применяются разные модели. Значение за пределами коридора считается аномалией.
Возможности
Шесть инструментов: от построения модели здоровья до поиска первопричин деградации.
Модель здоровья
Иерархический граф сервисов и их зависимостей: состояние каждого объекта рассчитывается из привязанных метрик и дочерних сервисов.
- Разные модели под задачу: бизнес-сервисы верхнего уровня, кластерная и контейнерная, микросервисная архитектура
- Коэффициенты влияния: каждой зависимости назначается вес
- Статические сервисы создаются вручную, динамические — по данным Инвентаризации
- Навигация и фильтрация по десяткам тысяч объектов
- Ролевая модель доступа к моделям и сервисам
Карточка сервиса
Полная картина конкретного сервиса: метрики, атрибуты актива и зависимости на одной странице.
- Привязанные метрики с текущим состоянием
- Атрибуты актива из системы инвентаризации
- Связанные сервисы и зависимости
- Здоровье сервиса и история изменения состояния
- Переход в «Исследования» для анализа
Исследования
Визуальный анализ и корреляция метрик на одной временной шкале: сопоставление изменений и выявление причинно-следственных связей между компонентами и сервисами.
- Визуальная корреляция «причина → следствие»
- Добавление метрик из любых сервисов модели
- Сохранение сценариев расследования и повторное использование
Анализ первопричин
Автоматизированный RCA: вероятные причины деградации сервиса определяются обходом графа зависимостей.
- Автоматический обход дерева зависимостей
- Учёт весов связей и временной последовательности
- Ранжированный список причин с уровнем влияния
- Таймлайн временного сдвига «причина → следствие»
- Диаграмма цепочки влияния
Центры аналитики
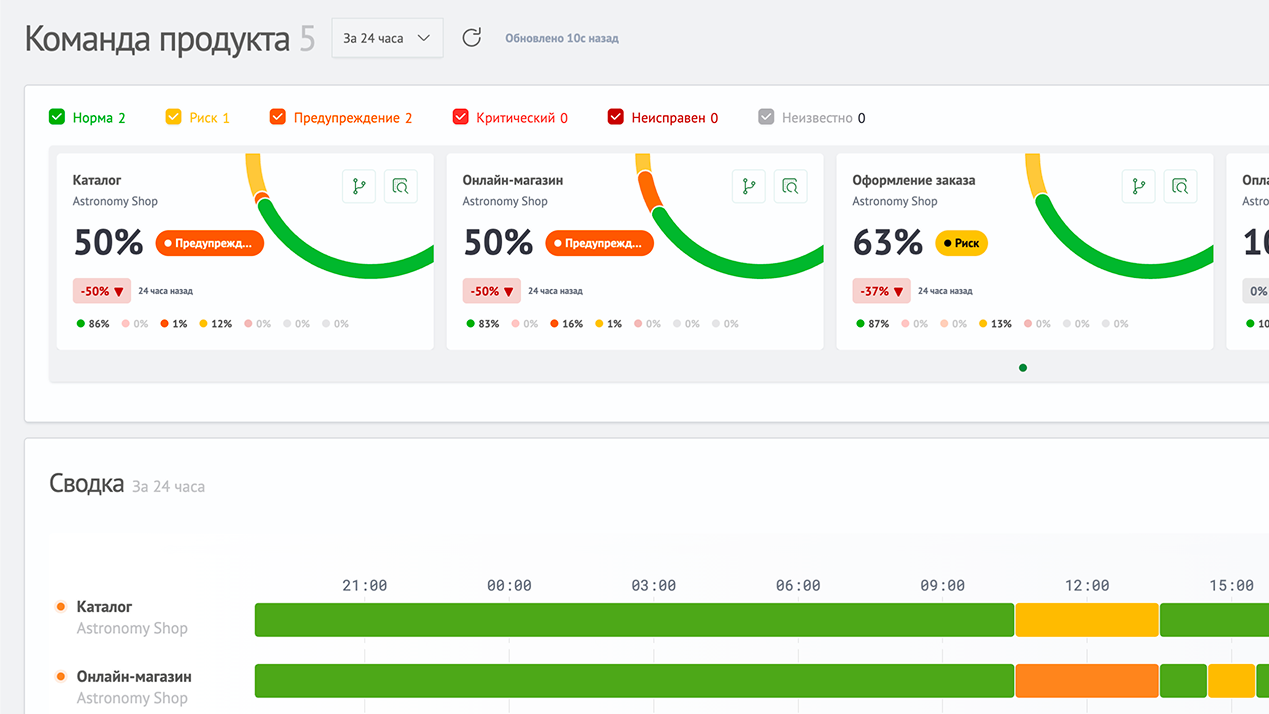
Единое окно оперативного мониторинга здоровья сервисов с персонализацией под роли и задачи — для бизнеса, эксплуатации, SRE- и ИТ-команд.
- Отдельное представление для каждой роли
- Плитки сервисов с цветовой индикацией состояния
- Таймлайн изменения состояний за период
- Статистика: доли состояний и тренды
- Переход в дерево модели или карточку одним кликом
Адаптивные метрики
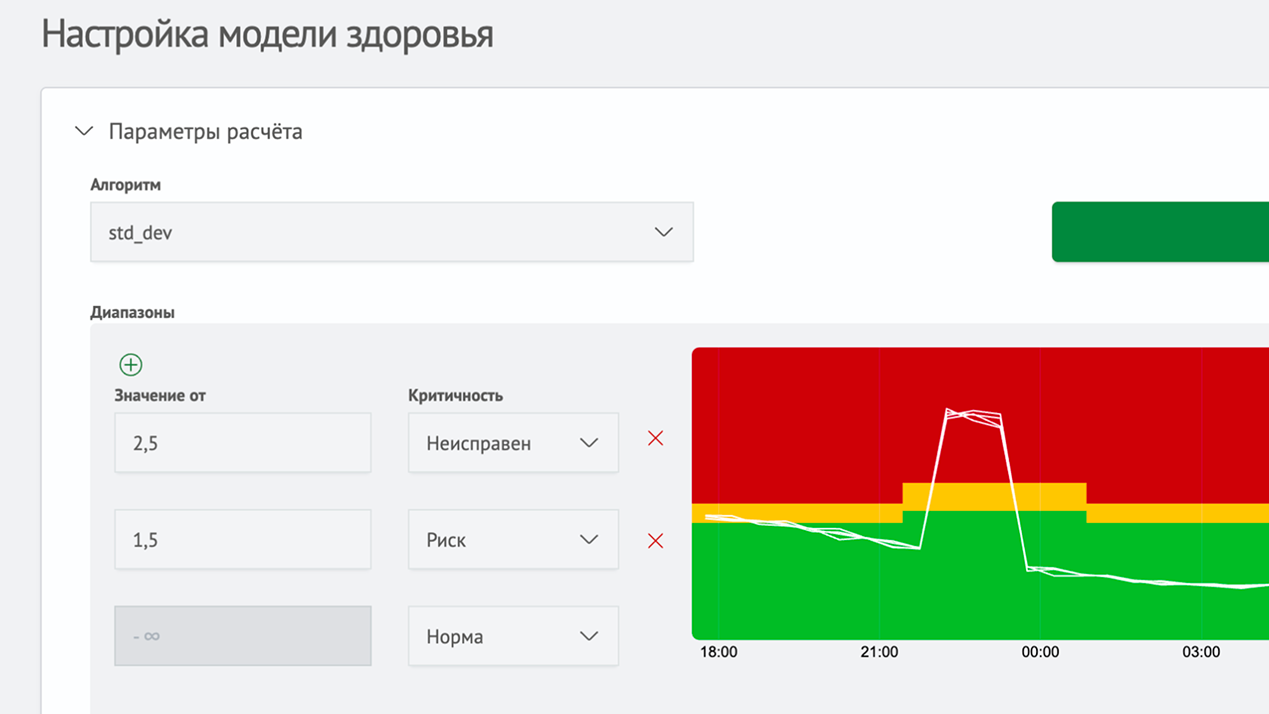
Диапазоны критичности рассчитываются по истории значений, а не задаются вручную: коридор нормы строится математическими алгоритмами и ML-моделями.
- Математические функции: σ по истории, перцентили, MAD
- Доверительные интервалы по временным окнам с учётом сезонности
- Временные окна: критичность зависит от времени и дней недели
- Разные модели для групп объектов по фильтрам
- Управление расчётами: статусы, история, перезапуск за период
Дополнительные инструменты
Инструменты для анализа состояния сервисов и реагирования.
SLI и SLO
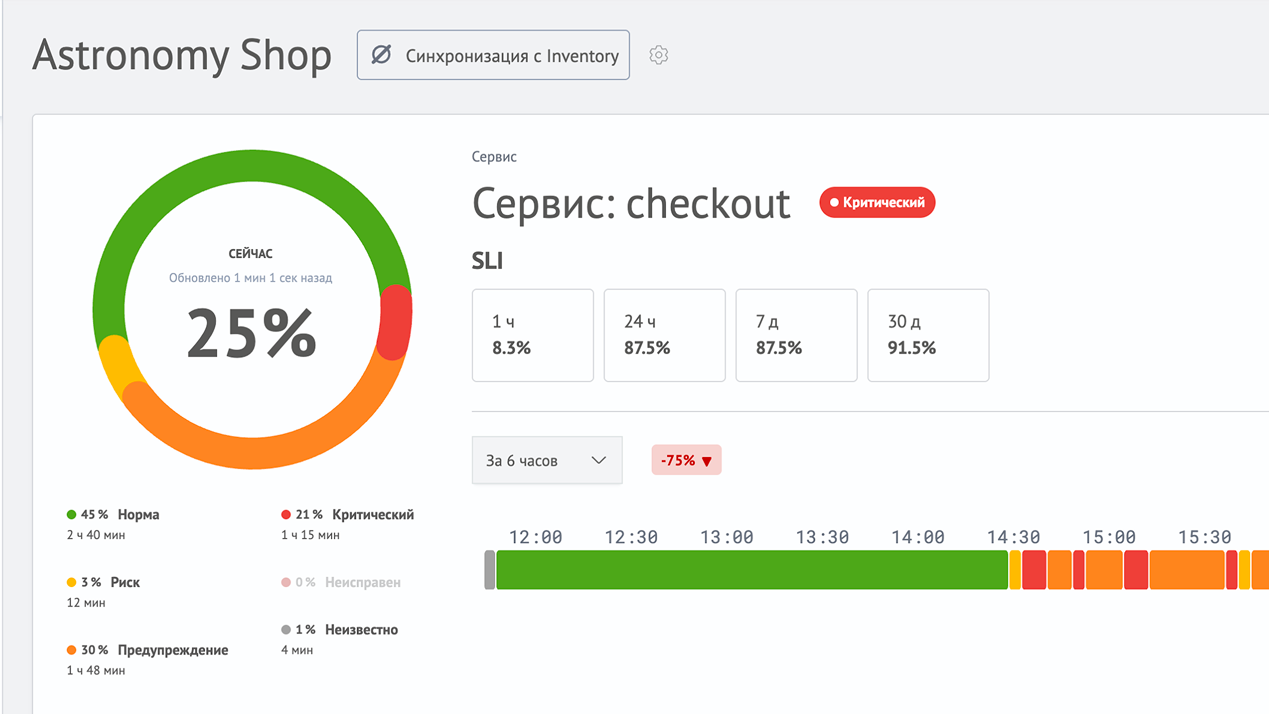
Расчёт SLI по фактическому здоровью сервисных объектов и сопоставление показателей с целевыми уровнями SLO/SLA.
- SLI «по факту» на основе здоровья сервиса
- Сравнение с целевыми значениями SLO
- Отчёты за неделю, месяц и квартал
- Учёт окон обслуживания в расчёте
Окна обслуживания
Интервалы, в течение которых состояние метрики не влияет на здоровье сервисов: плановые работы не попадают в модель здоровья.
- Плановые и внеплановые работы
- Подавление ложных срабатываний на время обслуживания
- Настройка по маскам и паттернам
- Исключения учитываются в SLI и анализе первопричин
Функциональные дашборды
Дашборды «под задачу» на штатных визуализациях платформы рядом с моделью здоровья.
- Конструктор с drag & drop панелей
- KPI, тренды и тепловые карты
- Исследование сырых данных поисковыми запросами
- Связь дашбордов с моделью здоровья
Инциденты по гибкой логике
Деградация сервиса превращается в инцидент Менеджера Инцидентов и проходит штатный жизненный цикл.
- Автоматическое создание инцидента при деградации сервиса
- SML-запросы для составных триггеров
- Полный цикл: создание → эскалация → решение